WAGBY11 MANUAL / 17
アップロード列・ヘッダ行数を設定する
入力ファイルの列を対象項目へ対応付け、ヘッダ行数に応じて名前または列位置で取り込めます。不要な列の扱いも指定できます。
最終更新日:
1. このページで伝える機能
入力ファイルの列を対象項目へ対応付け、ヘッダ行数に応じて名前または列位置で取り込めます。不要な列の扱いも指定できます。
2. Wagby11で実現できること
2.1 ヘッダ行数と列の対応
通常の在庫ファイルはヘッダ1行で、商品コードなどの名前を使って列を対応付けます。外部様式では先頭2行を読み飛ばし、3行目から列の位置で取り込みます。
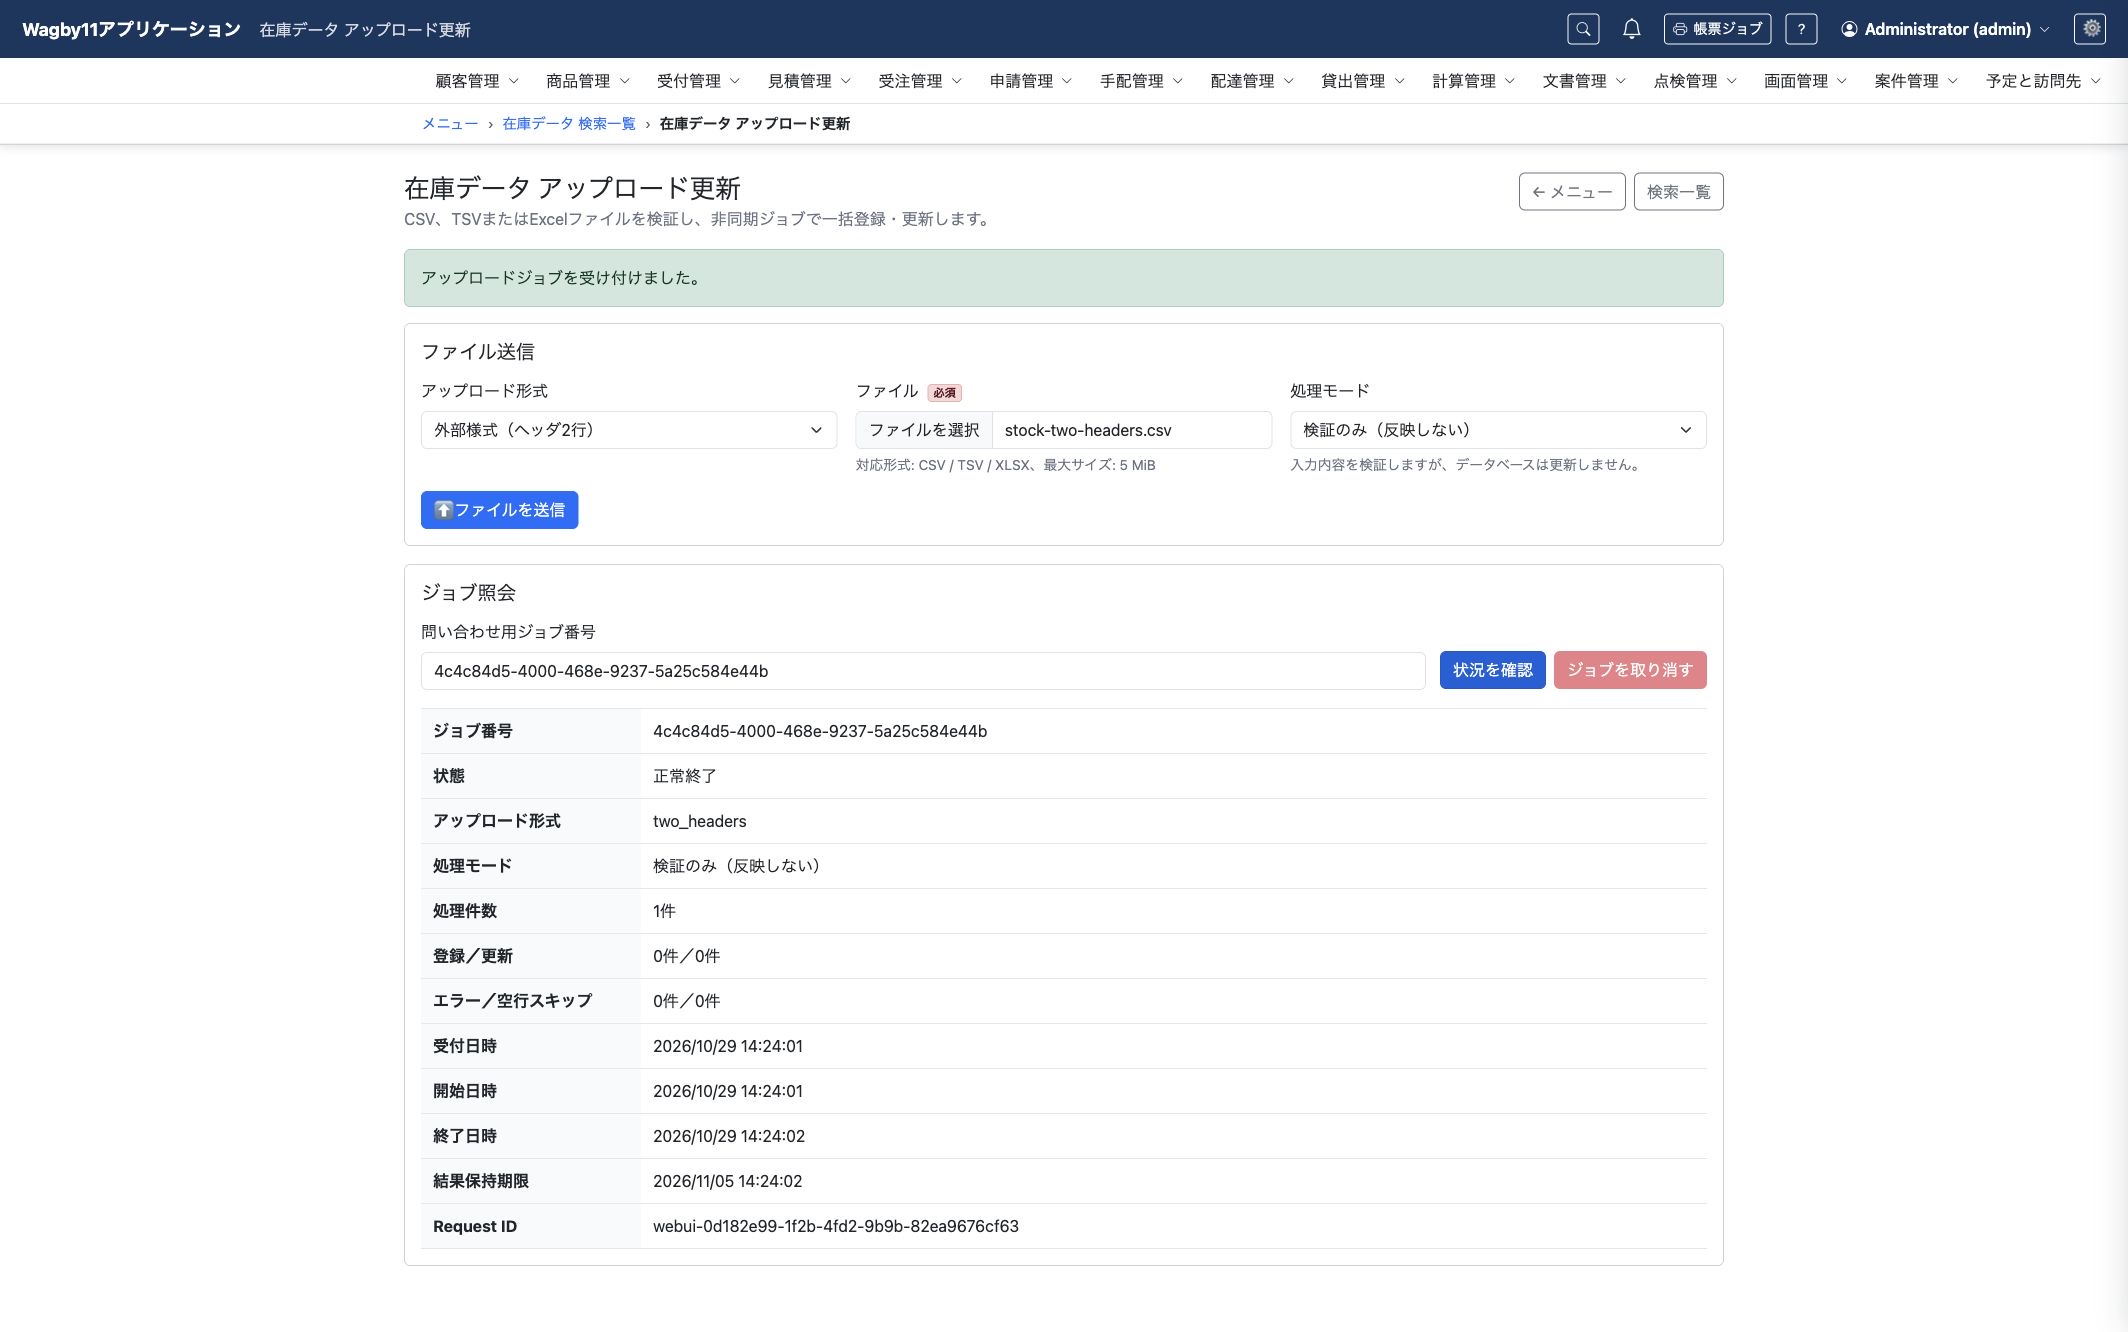
ヘッダなしは0行として1行目からデータを読みます。0行または2行以上ではcolumn1、column2などを列の物理位置に合わせます。1行の場合は列名による並べ替えも許可できます。
2.2 同じ名前のヘッダと複数の様式
ヘッダが1行のファイルでは、同じ列名が複数ある場合、最初の列はその名前を使い、2個目以降はcolumnNとして区別します。Nはファイルの左から数えた物理列番号です。同じ名前が何回目に現れたかを表す番号ではありません。
| 様式 | ファイルのヘッダ | 請求先住所 | 配送先住所 |
|---|---|---|---|
| A | 顧客ID,住所,住所 | 住所 | column3 |
| B | 顧客ID,住所,備考,住所 | 住所 | column4 |
この例では、様式ごとのアップロード定義を用意し、配送先住所へ対応付ける列名をAではcolumn3、Bではcolumn4とします。様式Bの備考を取り込まない場合も、その位置に読み飛ばす列を定義します。列の並べ替えを許可するだけでは、column3とcolumn4を同じ項目へ対応付けられません。
アップロード定義の列別設定は、その取り込みで使う列名を上書きします。モデルの共通の列名やダウンロードの出力名は変わりません。対応するダウンロード定義を切り替えるだけでは照合する列名は変わらず、出力ファイルをそのまま取り込めるとは限りません。空のヘッダや重複名を補正した後も、照合する列名が重複しないようにします。
2.3 不足する末尾ヘッダの補完
外部ファイルでデータは4列あるのにヘッダは先頭2列しかない場合、欠落した末尾ヘッダを補って取り込めます。ヘッダ1行のアップロードで補完を有効にすると、定義した列数までcolumn3、column4のように名前を補います。通常は補完せず、ヘッダ不足をエラーとして扱います。
たとえばヘッダが「顧客ID,顧客名」、データが「C001,山田太郎,東京都,100」のファイルなら、3列目をcolumn3、4列目をcolumn4へ対応付けます。これは、アップロード定義数を超える末尾列を読み飛ばす設定とは異なります。補完はヘッダだけが対象で、CSV・TSVのデータ行が定義列数より短ければエラーです。補完後の列名が重複する場合もエラーになります。
3. AIへの指示例
最小限の指示例
外部ファイルの先頭2行は見出しなので、3行目から在庫データを取り込んでください。AIはヘッダ行数、列位置、取り込まない列の扱いを類推して補います。実際のファイルの順番を伝えると、項目との対応が明確になります。
より詳細な指示例
外部様式用のアップロード定義を追加し、header.rowsを2、列の並べ替えは不可にしてください。1列目から商品コード、商品名、適用日、在庫数、単価、取扱中、備考へ対応付けます。各列にcolumn1〜column7を指定してください。
別の外部様式として、ヘッダ1行で「顧客ID,住所,住所」と「顧客ID,住所,備考,住所」の2種類を取り込めるようにします。請求先住所は住所、配送先住所は各様式のcolumn3とcolumn4へ対応付け、備考は読み飛ばしてください。
ヘッダが「顧客ID,顧客名」の2列だけで、データには住所と点数を含む4列ある様式も別に用意してください。欠落した末尾ヘッダだけを補完し、3列目を住所、4列目を点数に対応付けます。
既存のモデル・データ・権限を保持し、Wagby11のguide・referenceを確認してください。メニューと一般利用者向け操作マニュアルを更新し、生成・ビルド後に画面・出力ファイル・保存結果を確認してください。
4. 編集されるAppSchemaの例
以下は関連する定義の抜粋です。構文を覚えなくても、出力したい内容や取り込みの方針をAIへ伝えられます。
header: { rows: 2, required: true, exact: true, allow_reorder: false }
columns:
  - { name_en: productCode, upload: key, csv_name: column1 }
  - { name_en: productName, upload: writable, csv_name: column2 }
  - { name_en: effectiveDate, upload: writable, csv_name: column3 }
  - { name_en: quantity, upload: writable, csv_name: column4 }
  - { name_en: unitPrice, upload: writable, csv_name: column5 }
  - { name_en: active, upload: writable, csv_name: column6 }
  - { name_en: notes, upload: writable, csv_name: column7 }
途中の不要列は属性へ対応付けないskip、既存属性への反映だけを止める場合はignoreを使います。定義数を超える末尾列の無視と、途中列の読み飛ばしは別の扱いです。
同名の住所列を持つ2様式の例です。functions内のuploadsの抜粋で、対象モデルには顧客ID・請求先住所・配送先住所が定義されているものとします。
uploads:
  - id: address_a
    header: { rows: 1, required: true, exact: true, allow_reorder: false }
    columns:
      - { name_en: customerId, upload: key, csv_name: 顧客ID }
      - { name_en: billingAddress, upload: writable, csv_name: 住所 }
      - { name_en: shippingAddress, upload: writable, csv_name: column3 }
  - id: address_b
    header: { rows: 1, required: true, exact: true, allow_reorder: false }
    columns:
      - { name_en: customerId, upload: key, csv_name: 顧客ID }
      - { name_en: billingAddress, upload: writable, csv_name: 住所 }
      - { upload: skip, csv_name: 備考 }
      - { name_en: shippingAddress, upload: writable, csv_name: column4 }
末尾ヘッダを補う別のアップロード定義の抜粋です。この例の対象モデルは顧客ID・顧客名・住所・点数を持ちます。
header:
  rows: 1
  required: true
  exact: true
  allow_reorder: false
  allow_missing_trailing_columns: true
columns:
  - { name_en: customerId, upload: key, csv_name: 顧客ID }
  - { name_en: customerName, upload: writable, csv_name: 顧客名 }
  - { name_en: address, upload: writable, csv_name: column3 }
  - { name_en: points, upload: writable, csv_name: column4 }
5. 参考資料
- guide:アップロード列・ヘッダ行数を設定する
designer/docs/appschema/html/guide/09-data-transfer/14-upload-header-rows.html- reference:ファイルアップロード一括更新
designer/docs/appschema/html/reference/12-file-upload.html