WAGBY11 MANUAL / 06
案件固有の文字集合でチェックする
標準の文字集合へ記号や文字の範囲を加え、案件固有の許可文字を定義して複数項目の入力チェックに共用できます。
最終更新日:
1. このページで伝える機能
案件ごとに使える文字が決まっているコードなどに、名前を付けた文字集合を定義できます。標準の文字集合、Unicodeの範囲、個別の文字を組み合わせ、複数の項目から同じ定義を参照します。AppSchemaの標準機能で指定でき、Javaカスタマイズは不要です。
2. Wagby11で実現できること
2.1 許可する文字を組み合わせる
案件コードと文書コードに、半角英数字と半角のハイフン(-)・アンダースコア(_)だけを使えるようにする例です。標準の半角英数字の文字集合に2つの記号を加え、案件用の文字集合として名前を付けます。英字は大文字・小文字の両方を許可します。
| 入力例 | 結果 |
|---|---|
| PJ-2026_A | 許可した文字だけなので受け付けます。 |
| DOC_01 | 同じ文字集合で受け付けます。 |
| PJ/2026 | スラッシュが含まれるためエラーです。 |
| PJ-2026 | 全角英字が含まれるためエラーです。 |
| PJ 2026 | 半角空白も許可していないためエラーです。 |
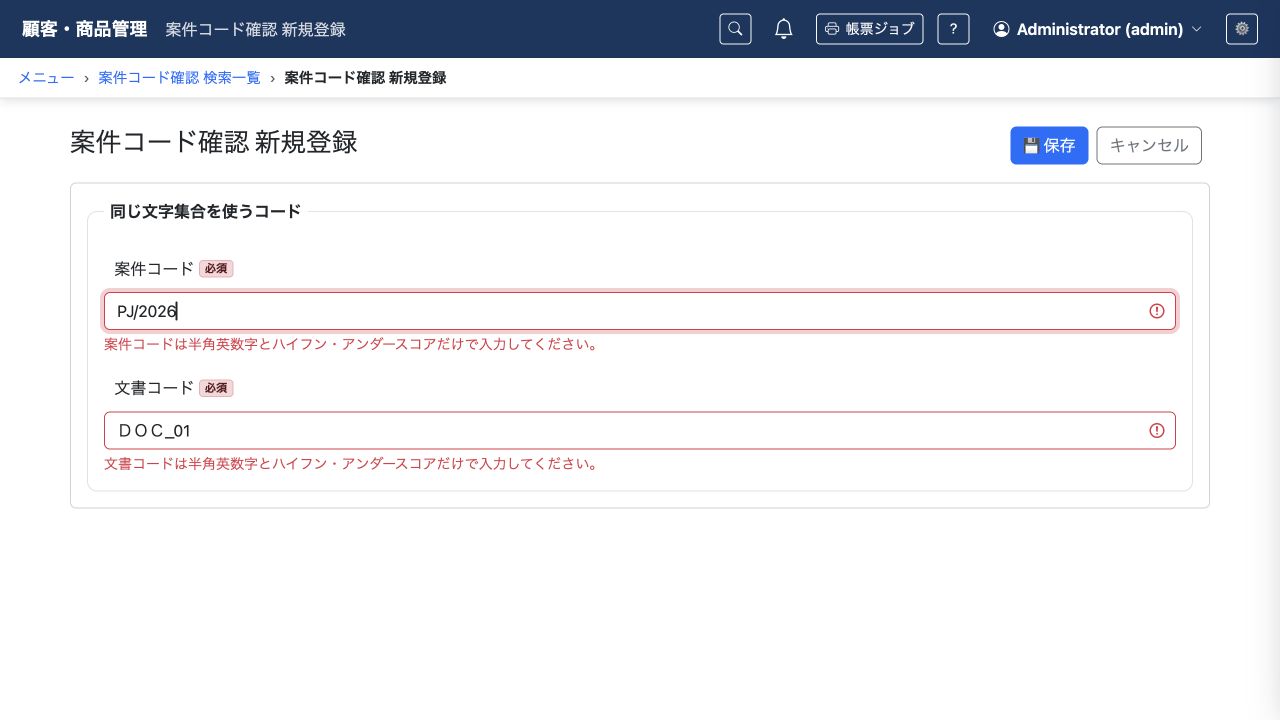
文字集合に含まれない文字を自動で削除したり、半角へ補正したりする設定ではありません。入力した文字をそのまま検証し、エラーなら利用者が修正します。
2.2 同じ文字集合を複数項目で使う
案件コードと文書コードは、同じ名前の文字集合を入力チェックのpresetとして参照します。許可する記号が変わった場合も、共通の定義を見直して反映できます。同じ定義を参照するほかの項目への影響も確認します。
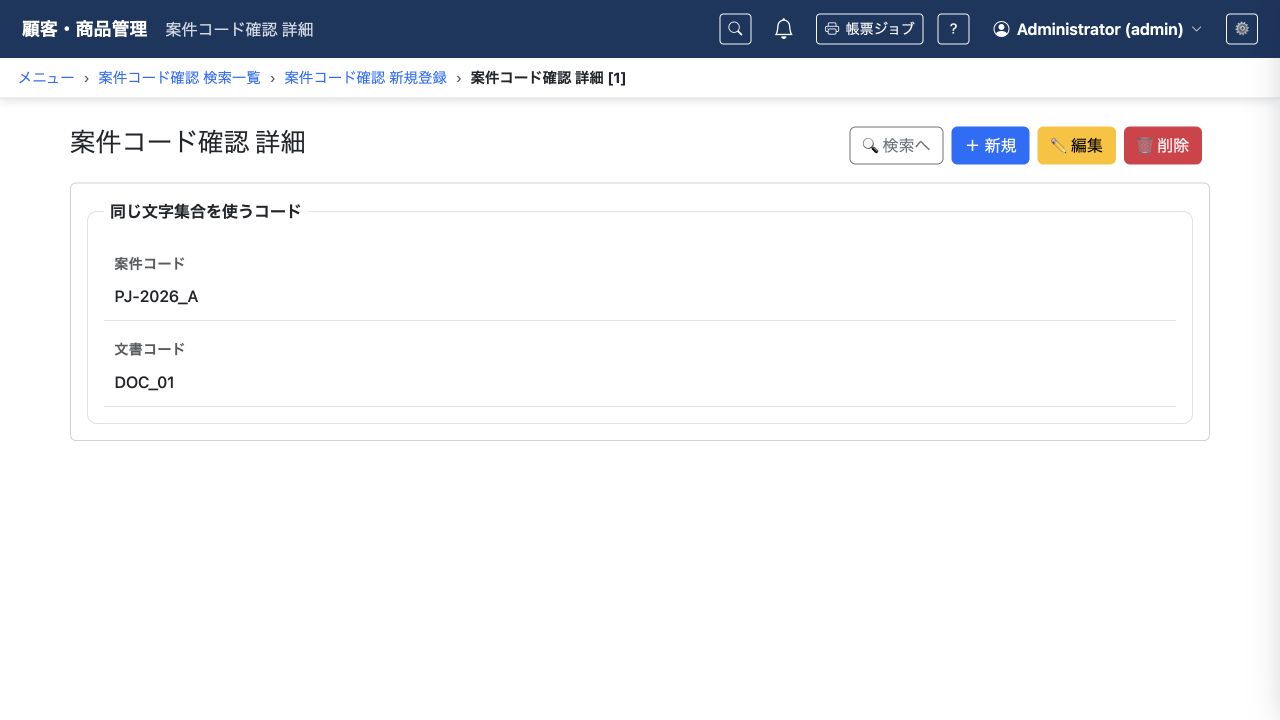
ブラウザーの入力時とサーバーの登録・更新時で、標準機能による同じ文字の制約を使います。定義の変更後は通常の再生成・必要なビルドを行い、REST APIとWeb UIを起動して確認します。
2.3 文字の並びや必須入力と使い分ける
文字集合presetは、未入力の必須チェックを兼ねません。この例では案件コードと文書コードを必須にする設定も加えています。文字数の上限も別に指定します。必要に応じて必須チェックや長さのチェックと組み合わせます。
文字集合には標準の集合や別の案件固有の集合を含められ、個別のUnicodeコードポイントや範囲も追加できます。定義名は重複させず、標準presetを同じ名前で上書きしません。
個別指定と範囲で追加できるのは、Unicodeの基本多言語面(BMP)に含まれる非サロゲート文字です。BMP外の文字は、この文字集合の定義へ追加できません。emailは文字の配置も確認する構造パターンなので、文字集合のincludeには使いません。
3. AIへの指示例
最小限の指示例
案件コードと文書コードは、半角英数字とハイフン・アンダースコアだけを受け付けてください。許可する文字の定義を共用したいです。AIは対象項目、共通の文字集合の名前、必須かどうか、長さやエラーメッセージを類推して補います。空白や全角文字の扱い、許可する記号を具体的に伝えると、意図が明確になります。最小限の指示だけで次の詳細例と同じ仕様になるとは限りません。
より詳細な指示例
案件コード確認CharacterSetSampleに、案件コードprojectCodeと文書コードdocumentCodeを用意してください。どちらも文字列40文字以内で、登録・更新時は必須です。
rootdefsの追加定義にmanual_project_codeという文字集合を一度だけ定義し、標準のascii_alphanumericと、半角ハイフンU+002D・アンダースコアU+005Fを組み合わせます。両項目のpattern制約から同じpresetを参照してください。Javaカスタマイズは使いません。
全角英数字、スラッシュ、空白を許可せず、自動補正もしません。案件コードにPJ-2026_A、文書コードにDOC_01を保存でき、PJ/2026やPJ-2026では入力エラーになることを確認してください。画面とAPIの登録・更新で確認します。
既存の定義・データ・権限・migration_idを保持し、guide・referenceを確認してください。メニューと利用者向け操作マニュアルを用意し、定義の検証・生成・ビルド・起動を行ってください。
4. 編集されるAppSchemaの例
共通の文字集合は、ルートのappschema.yamlまたはrootdefsの追加定義へ置きます。次はrootdefs/character-set-manual.yamlの例です。モデルの属性定義の中へ置くものではありません。
validation_catalog:
  character_sets:
    manual_project_code:
      include: [ascii_alphanumeric]
      code_points: [U+002D, U+005F]
各項目では、定義した名前をpresetへ指定します。モデルの関連部分だけを示しています。
entity:
  attributes:
    - name: 案件コード
      name_en: projectCode
      type: string
      length: 40
      validation:
        presence: { create: error, update: error }
        constraints:
          - id: PROJECT_CODE_CHARACTERS
            type: pattern
            preset: manual_project_code
            severity: error
            operations: [CREATE, UPDATE]
            message_code: error.manual.project.characters
    - name: 文書コード
      name_en: documentCode
      type: string
      length: 40
      validation:
        presence: { create: error, update: error }
        constraints:
          - id: DOCUMENT_CODE_CHARACTERS
            type: pattern
            preset: manual_project_code
            severity: error
            operations: [CREATE, UPDATE]
message_code: error.manual.document.charactersincludeは文字集合の合成、code_pointsは個別文字の追加です。rangesでfrom・toのUnicode範囲を追加することもできます。許可する文字と入力例をAIへ伝えれば、構文の習得を前提にせず定義を用意できます。メッセージ文言は入力チェックメッセージの方法で管理します。
5. 参考資料
- guide:正規表現チェック
designer/docs/appschema/html/guide/04-validation/07-regular-expression.html- reference:入力チェック定義
designer/docs/appschema/html/reference/11-validation.html- reference:ルートスキーマ
designer/docs/appschema/html/reference/02-root-schema.html